Deep Learning Revision
581
구독자
10
영상
최근 영상
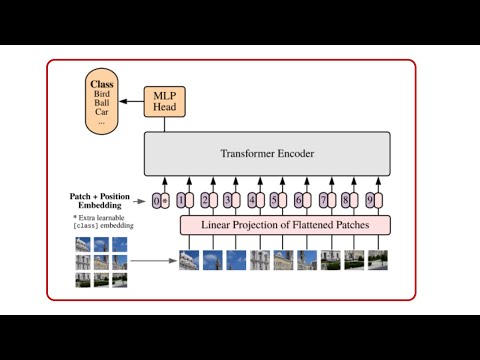
Vision Transformer(ViT) Architecture Explained | Deep Learning Clips

Vision Transformer(ViT) - Image is worth 16x16 words | Paper Explained

Transformer Architecture: Attention is All you Need Paper Explained

Making Data-Driven Decisions

Machine Learning is Transforming Almost Everything

Learning, Applying, and Making ML Rewarding

Deep AI & Vision Case Study: Self Driving Car

PIE & AI Kigali – Building a Career in Data Science: From Learning to Landing a Job

Pie & AI: Kigali, Rwanda: Breaking into AI

Deep AI & Vision Case Study: Self Driving Car